从零开始理解 KMP、Z 函数和 AC 自动机
这篇是整理 KMP、Z 函数、AC 自动机时的学习笔记。最开始容易混在一起的几个问题是:
- KMP 为什么能从暴力匹配的回退中省掉重复比较;
- Z 函数和 KMP 为什么都在处理“前缀匹配”,但视角不同;
- AC 自动机为什么可以看成“很多个 KMP 同时跑”。
先记一个共同点:它们都在处理匹配失败后的信息复用。
参考资料里,宫水三叶在 LeetCode 讨论区的字符串算法整理给了一个很好的学习入口;具体定义和实现细节我主要对照了 cp-algorithms 的 KMP、Z 函数和 Aho-Corasick 页面。
先从最朴素的问题开始
给一个文本串 text 和一个模式串 pattern,问 pattern 在 text 里出现在哪里。
例如:
1
2
text    = ababcababd
pattern =     ababd
最直接的暴力做法是:枚举 text 的每个起点,然后把 pattern 从头到尾比一遍。
1
2
3
4
5
6
7
8
9
10
11
12
def brute_force(text, pattern):
    n, m = len(text), len(pattern)
    ans = []
    for i in range(n - m + 1):
        ok = True
        for j in range(m):
            if text[i + j] != pattern[j]:
                ok = False
                break
        if ok:
            ans.append(i)
    return ans
这段代码非常直观,但问题也明显:如果前面已经匹配了很多字符,最后一个字符才失败,下一轮又从模式串开头重新比,前面那些信息就被浪费了。
暴力算法的核心浪费是:
1
2
已经知道某一段等于 pattern 的前缀,
但失败后仍然把 pattern 整体右移一格,从头再试。
KMP、Z 函数、AC 自动机都是围绕这个浪费展开的。
一个关键词:border
在进入 KMP 之前,先理解一个词:border。
一个字符串的 border,是它的某个“真前缀”,同时也是它的“后缀”。
比如:
1
2
3
4
5
6
7
s = ababab

前缀: a, ab, aba, abab, ababa
后缀: b, ab, bab, abab, babab

border: ab, abab
最长 border: abab
注意“真前缀”不包括字符串自己。所以 ababab 自己不能算自己的 border。
为什么 border 重要?因为它告诉我们:当一段匹配失败时,哪些已经匹配过的尾巴,可以继续当作下一轮匹配的开头。
例如已经匹配了 ababcabab,它的最长 border 是 abab:
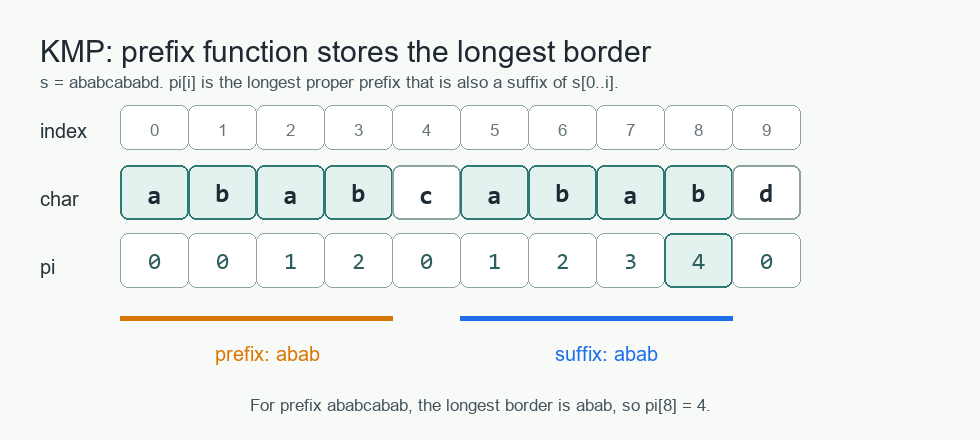
这里的意思是:前面那段 abab 和末尾那段 abab 是一样的。如果后面匹配失败,不需要回到 0,可以直接把当前已经匹配的长度退到 4。
KMP:失败时应该退到哪里
KMP 维护的是模式串的 pi 数组,也叫 prefix function。
定义:
1
pi[i] = pattern[0..i] 的最长 border 长度
举例:
1
2
3
4
pattern = ababcababd
index     0 1 2 3 4 5 6 7 8 9
char      a b a b c a b a b d
pi        0 0 1 2 0 1 2 3 4 0
读这个数组时不要急着想代码,先想语义:
pi[3] = 2,因为abab的最长 border 是ab;pi[8] = 4,因为ababcabab的最长 border 是abab;pi[9] = 0,因为ababcababd没有非空 border。
KMP 匹配时会维护一个变量 j,表示当前已经匹配了模式串前 j 个字符。
当 text[i] == pattern[j] 时,j += 1。
当 text[i] != pattern[j] 时,暴力算法会把模式串整体右移,然后 j 回到 0。KMP 不这样做。它会让:
1
j = pi[j - 1]
这句话的含义是:
1
2
3
4
当前已经匹配了 pattern[0..j-1]。
现在第 j 个字符失败。
那我应该保留这段已匹配前缀的最长 border,
因为这个 border 既是前缀,也是当前文本尾部已经匹配出来的后缀。
完整代码如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
def prefix_function(s):
    pi = [0] * len(s)
    for i in range(1, len(s)):
        j = pi[i - 1]
        while j > 0 and s[i] != s[j]:
            j = pi[j - 1]
        if s[i] == s[j]:
            j += 1
        pi[i] = j
    return pi


def kmp_search(text, pattern):
    if not pattern:
        return list(range(len(text) + 1))

    pi = prefix_function(pattern)
    ans = []
    j = 0

    for i, ch in enumerate(text):
        while j > 0 and ch != pattern[j]:
            j = pi[j - 1]

        if ch == pattern[j]:
            j += 1

        if j == len(pattern):
            ans.append(i - len(pattern) + 1)
            j = pi[j - 1]

    return ans
代码里两处 j = pi[j - 1] 含义相同:找一个更短、但仍然可能成立的 border 继续试。失配时回退,是为了避免从模式串开头重新比较;完整匹配后回退,是为了保留重叠匹配。例如在 aaaaa 里找 aaa,答案是位置 0, 1, 2。
KMP 的线性复杂度来自一个事实:文本指针 i 不回退,只有模式串状态 j 回退;j 的增加和减少总次数都受字符串长度限制。
Z 函数:另一种看前缀匹配的方式
Z 函数的定义比 KMP 更直接:
1
z[i] = s 和 s[i..] 的最长公共前缀长度
也就是说,z[i] 问的是:
1
从位置 i 开始的后缀,能和整个字符串开头匹配多长?
例子:
1
2
3
s     = aabcaabxaaaz
index   0 1 2 3 4 5 6 7 8 9 10 11
z       0 1 0 0 3 1 0 0 2 2 1  0
看 i = 4:
1
2
3
4
s        = a a b c a a b x a a a z
s[4..]   =         a a b x a a a z

公共前缀是 aab,所以 z[4] = 3
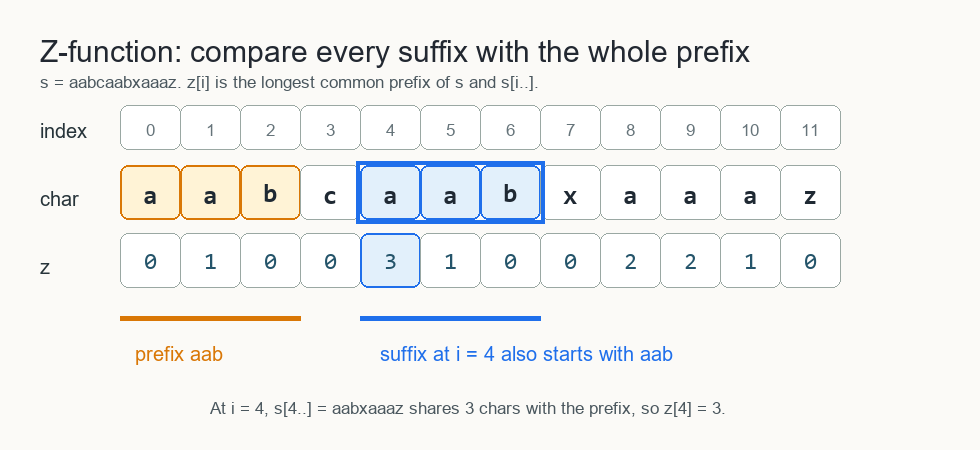
如果直接计算每个 z[i],做法就是从 i 开始和字符串开头一个个比。这样会重复比较很多字符。Z 函数的线性写法用一个已经匹配过的区间来减少重复比较。
这个区间通常写成 [left, right),也叫 Z-box。它的含义是:
1
s[left..right) 已经确认等于 s[0..right-left)
也就是从 left 开始的一段子串,和字符串开头的一段完全相同。这里 right 不包含在区间内,所以区间长度是 right - left。
如果新的位置 i 落在这个区间里,说明 i 附近的一部分字符已经间接比较过了,可以先借用之前的结果:
1
z[i] = min(right - i, z[i - left])
其中 i - left 是 i 在 Z-box 里的相对位置。因为 Z-box 这段等于字符串开头,所以这个相对位置可以对应到开头处已经算过的 Z 值。
如果借来的长度正好碰到 right 边界,就再从 right 往后继续比较。每次真正的新比较都会把 right 往右推,所以整体是 O(n)。
Z 函数也可以用来做单模式串匹配。构造一个新串:
1
combined = pattern + "#" + text
其中 # 是一个不会出现在原字符串里的分隔符。
如果某个位置 i 的 z[i] == len(pattern),说明从 combined[i] 开始,完整匹配了 pattern。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
def z_function(s):
    z = [0] * len(s)
    left = right = 0

    for i in range(1, len(s)):
        if i < right:
            z[i] = min(right - i, z[i - left])

        while i + z[i] < len(s) and s[z[i]] == s[i + z[i]]:
            z[i] += 1

        if i + z[i] > right:
            left = i
            right = i + z[i]

    return z


def z_search(text, pattern):
    if not pattern:
        return list(range(len(text) + 1))

    sep = "#"
    combined = pattern + sep + text
    z = z_function(combined)
    m = len(pattern)
    ans = []

    for i in range(m + 1, len(combined)):
        if z[i] >= m:
            ans.append(i - m - 1)

    return ans
KMP 和 Z 函数的区别
两者都能做单模式串匹配,复杂度也一样。区别主要是视角:
| 算法 | 数组含义 | 更像在问什么 |
|---|---|---|
| KMP / prefix function | 每个前缀的最长 border | 当前匹配失败后,应该退到哪个状态? |
| Z 函数 | 每个后缀和整个字符串前缀匹配多长 | 从这里开始,能和开头匹配多长? |
简单记:KMP 更像“匹配状态机”,Z 函数更像“每个位置和开头对齐”。求周期时 KMP 顺手;需要知道每个位置和前缀能匹配多长时,Z 函数更直接。
多个模式串怎么办
前面讲的是一个 pattern 去匹配一个 text。
如果有很多模式串呢?
比如有四个关键词:
1
2
3
4
he
she
his
hers
现在要在文本 ushers 里找出所有出现的关键词。
最笨的方法是对每个关键词跑一遍 KMP:
1
2
3
4
he   vs text
she  vs text
his  vs text
hers vs text
如果关键词很多,这样会重复扫描文本很多次。
AC 自动机解决的是多模式串匹配。它的思路是:
1
2
3
把所有模式串放进一棵 trie;
再给 trie 上的每个节点加 fail 指针;
扫描文本时只走一遍。
AC 自动机第一步:把模式串放进 trie
Trie 是前缀树。
把 he, she, his, hers 插进去,会得到一棵共享前缀的树:
1
2
3
4
5
6
7
8
9
10
root
├── h
│   ├── e        -> he
│   │   └── r
│   │       └── s -> hers
│   └── i
│       └── s     -> his
└── s
    └── h
        └── e     -> she
Trie 能解决“多个模式串共享前缀”的问题,但还不能解决匹配失败后的跳转。
比如扫描 ushers:
1
u s h e r s
走到 s -> h -> e 时,我们匹配到了 she。但同一段末尾的 he 也应该被发现。
这就需要 fail 指针。
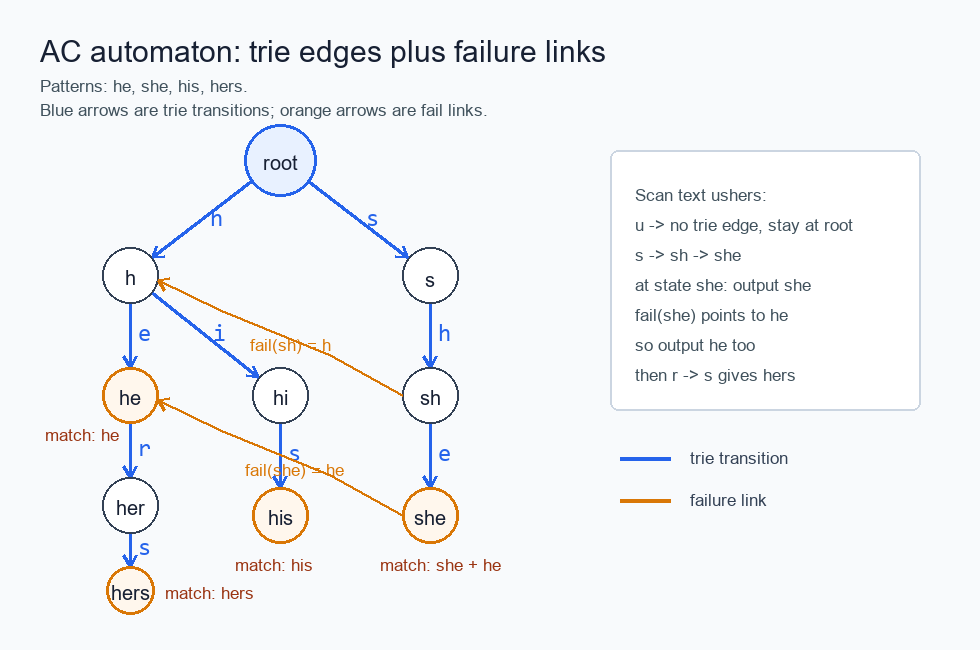
fail 指针:多模式串版本的 border
AC 自动机里,一个节点代表从 root 到该节点的字符串。
比如节点 she 代表字符串 "she"。
fail(she) = he 的含义是:
1
"she" 的最长后缀里,仍然是某个 trie 节点的,是 "he"。
这和 KMP 的 pi 很像。
KMP 的失败回退是:
1
当前模式串前缀匹配失败 -> 退到这个前缀的最长 border
AC 自动机的失败回退是:
1
当前 trie 节点无法沿字符 c 继续走 -> 沿 fail 指针退到另一个后缀状态
所以可以粗略理解成:
AC 自动机是把很多模式串合成一棵 trie,然后给 trie 的每个节点补上类似 KMP 的失败回退。
AC 自动机怎么构建
AC 自动机有三步:
- 把所有模式串插入 trie;
- 用 BFS 构建 fail 指针;
- 扫描文本,沿 trie 边和 fail 边转移,并在终止节点输出匹配。
下面是一份偏教学版的 Python 代码:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
from collections import deque


class Node:
    def __init__(self):
        self.next = {}
        self.fail = 0
        self.out = []


class AhoCorasick:
    def __init__(self):
        self.nodes = [Node()]

    def add(self, word, word_id):
        cur = 0
        for ch in word:
            if ch not in self.nodes[cur].next:
                self.nodes[cur].next[ch] = len(self.nodes)
                self.nodes.append(Node())
            cur = self.nodes[cur].next[ch]
        self.nodes[cur].out.append(word_id)

    def build(self):
        q = deque()

        for ch, nxt in self.nodes[0].next.items():
            self.nodes[nxt].fail = 0
            q.append(nxt)

        while q:
            cur = q.popleft()

            for ch, nxt in self.nodes[cur].next.items():
                f = self.nodes[cur].fail

                while f and ch not in self.nodes[f].next:
                    f = self.nodes[f].fail

                if ch in self.nodes[f].next:
                    self.nodes[nxt].fail = self.nodes[f].next[ch]
                else:
                    self.nodes[nxt].fail = 0

                self.nodes[nxt].out.extend(self.nodes[self.nodes[nxt].fail].out)
                q.append(nxt)

    def search(self, text):
        cur = 0
        ans = []

        for i, ch in enumerate(text):
            while cur and ch not in self.nodes[cur].next:
                cur = self.nodes[cur].fail

            if ch in self.nodes[cur].next:
                cur = self.nodes[cur].next[ch]
            else:
                cur = 0

            for word_id in self.nodes[cur].out:
                ans.append((i, word_id))

        return ans
这里 out 保存的是“有哪些模式串在这个节点结束”。
构建 fail 指针时有一行很重要:
1
self.nodes[nxt].out.extend(self.nodes[self.nodes[nxt].fail].out)
它表示:如果当前节点匹配成功,那么它的 fail 链上能输出的短模式串也应该一起输出。
例如到达 she 时,除了输出 she,还要沿 fail 找到 he,所以 he 也要输出。
这里有两种等价写法:
1
2
写法一:构建时把 fail 节点的 out 合并到当前节点。
写法二:匹配时从当前节点沿 fail 链一路检查输出,直到 root。
上面的代码用的是第一种写法,所以到达 she 节点时,he 已经被提前合并进 she 的 out 里。概念上仍然可以理解成:先输出 she,再看 fail(she) = he,发现 he 也是一个模式串,于是输出 he,然后继续看 fail(he)。
用 ushers 手走一遍
模式串:
1
he, she, his, hers
文本:
1
ushers
扫描过程大概是:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
读 u:
    root 没有 u,仍在 root

读 s:
    root -> s

读 h:
    s -> sh

读 e:
    sh -> she
    输出 she
    fail(she) = he
    也输出 he
    fail(he) = root,root 没有输出,所以这条输出链结束

读 r:
    当前真实状态仍然是 she
    she 没有 r,于是沿 fail 到 he
    he 有 r,走到 her

读 s:
    her -> hers
    输出 hers
最终找到:
1
2
3
she
he
hers
这就是 AC 自动机的价值:文本只扫描一遍,但多个模式串都能同时匹配出来。
三个算法放在一起
现在回头看,三者的关系会清楚很多:
| 算法 | 解决的问题 | 核心记忆 | 失败时怎么做 |
|---|---|---|---|
| KMP | 单模式串匹配 | 每个前缀的最长 border | j = pi[j - 1] |
| Z 函数 | 每个位置和前缀匹配多长 | 当前最右 Z-box | 复用 box 内结果,再向右扩展 |
| AC 自动机 | 多模式串匹配 | trie 节点的 fail 指针 | 沿 fail 链退到可继续匹配的后缀状态 |
匹配失败不等于信息清零。KMP 把可复用的后缀长度存在 pi 数组里;Z 函数把它体现在 Z-box 的复用里;AC 自动机把它扩展到 trie 上,变成每个节点的 fail 指针。
整理这三个算法时,可以只问两个问题:它保存了哪种已比较信息,失败时又跳到哪里。